2026年AI数据中心功率容量翻倍,企业部署AI应用时应如何估算电力成本2026 年,随着 AI 计算需求的激增,斯坦福 AI 指数报告指出,AI 数据中心的功率容量整体翻倍。对企业而言,电力支出已成为 AI 项目总拥有成本(TCO)中不可忽视的一块。了解如何在预算阶段量...AI智能# GPU# 算力# 能源管理1个月前1250
AI模型训练碳排放持续攀升,企业如何建立可量化的绿色AI评估指标当大模型训练动辄消耗数万吨二氧化碳时,把环境成本纳入AI选型已经不再是可选项。斯坦福AI指数2026年报告显示,Grok 4单次训练排放约7.3万吨二氧化碳,数据中心功率容量在过去一年翻倍增长。这些数...AI智能# GPU# 大模型# 模型训练1个月前850
AI智能体本地部署的最后一公里:环境依赖与OpenClaw运行调优企业把 AI 智能体从云端迁到本地,最常踩的坑往往不在模型本身,而在环境依赖和运行调优这两道坎上。云端环境统一、资源充足,很多问题被天然屏蔽;一旦落到端侧或自建服务器,CPU 架构、内存大小、依赖版本...AI智能# GPU# 大模型# 显存1个月前1550
企业私有化部署小模型的“性价比”陷阱:什么时候该放弃本地化?在数字化转型浪潮中,许多CTO与IT架构师正面临一个关键抉择:是继续依赖公有云API服务,还是投资私有化部署小模型以保障数据安全和降低长期调用成本?私有化小模型确实能在算力成本、维护人力与模型精度三者...AI智能# AI应用# GPU# 医疗1个月前1650
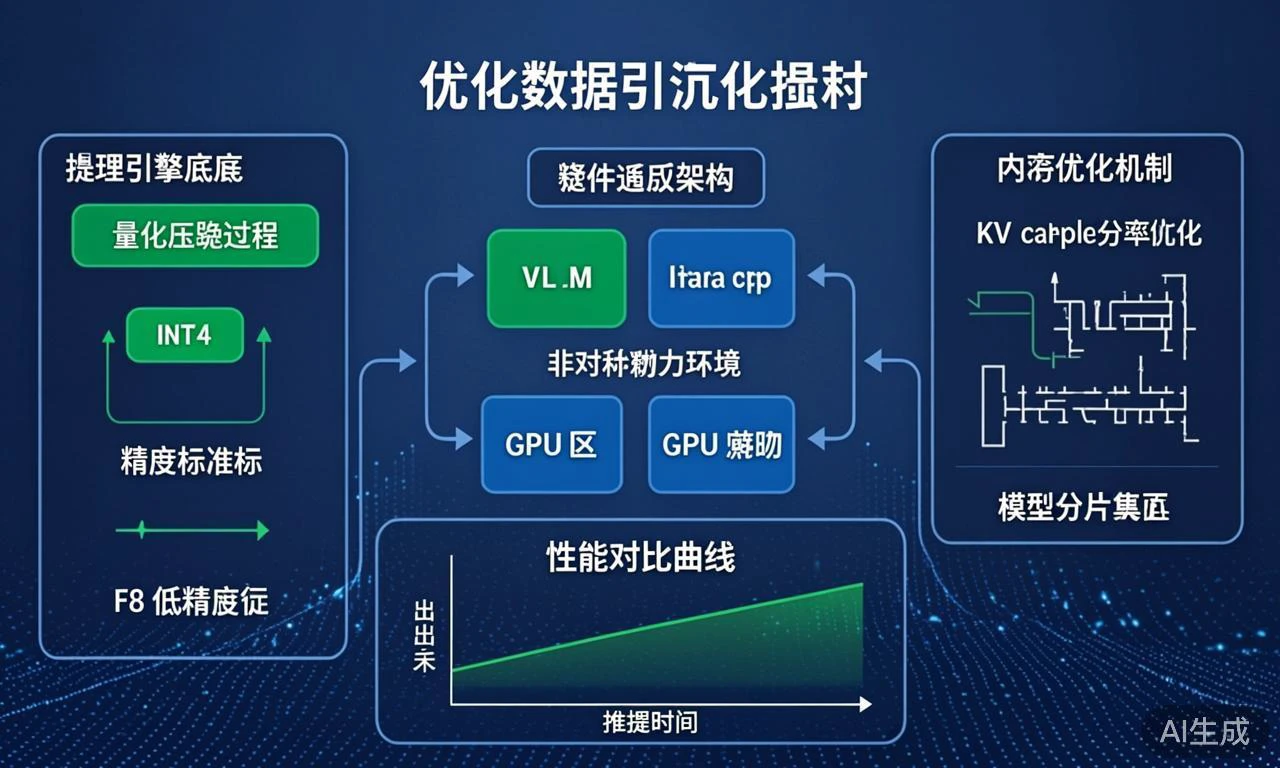
AI 智能体本地部署的‘最后 1 公里’:如何优化推理引擎以适配非对称算力环境本地部署AI智能体时,推理引擎的适配直接决定了部署的成败。在面对CPU算力强但GPU显存不足或非对称算力环境时,单纯依赖硬件往往不够高效。量化技术和先进推理框架的组合是优化这一“最后一公里”的核心策略...AI智能# GPU# 推理引擎# 显存1个月前1950
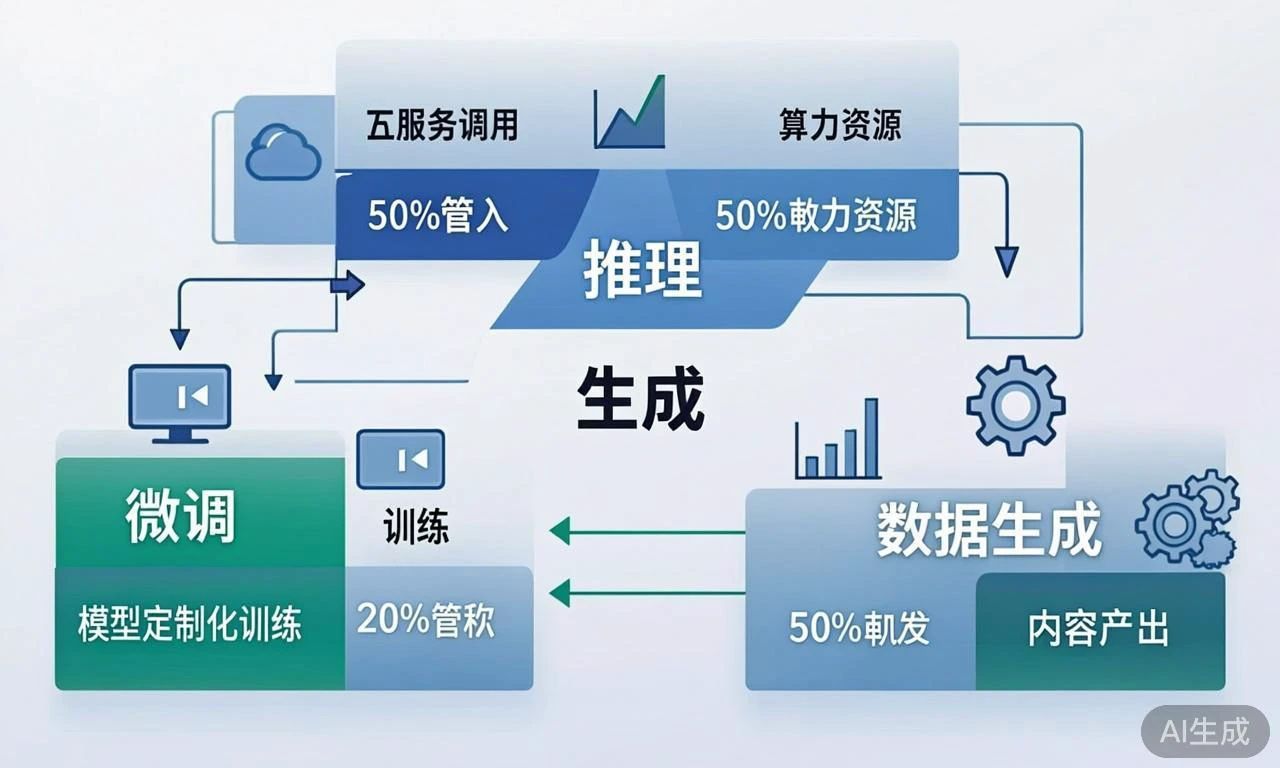
从单模型导出转向端到端方案:AI 出海企业如何构建“算力+模型+应用”闭环在全球 AI 产业加速工业化的背景下,越来越多中国企业尝试将技术输出到海外市场。过去的出海路径往往是把训练好的大模型直接交付给海外客户,或仅提供模型导出 SDK,让对方自行部署。然而,单纯的模型能力已...AI智能# GPU# 图像生成# 自动化办公1个月前1850
AI项目预算应怎样按任务核算,而不是按模型参数估算在实际的 AI 项目中,预算往往被误导为只看模型的参数规模或训练时长,而忽略了业务层面的真实消耗。财务与项目管理者如果继续沿用“每千万参数多少美元”的估算方式,容易导致资源错配——高参数模型并不一定等...AI智能# GPU# 大模型# 工作流1个月前2350
AI 智能体本地部署避坑:从环境依赖到 OpenClaw 运行调优本地把 AI 智能体跑起来,往往不是卡在“会不会写 Prompt”,而是卡在环境:CUDA 对不上、Python 包互相踩脚、运行时版本混用、配置里 skill 或 MCP 连不上。OpenClaw ...AI智能# GPU# Transformer# 工作流1个月前1600
Qwen3.8-27B 本地运行指南:17GB 显存环境下如何平衡性能与速度阿里把 Qwen3.8-27B 推到消费级硬件上时,最吸引人的不是参数量本身,而是官方与社区反复提到的一点:合适量化后,大约 17GB 内存/显存量级就能把模型拉起来。对只有一张中端卡、又想本地跑通编...AI智能# GPU# 上下文窗口# 多模态1个月前2150
AI 智能体本地部署避坑指南:从环境搭建到 OpenClaw 实战在快速发展的AI领域,本地部署AI代理已成为许多用户的选择,因为它能最大程度保障数据隐私和控制权。然而,这并不意味着零成本。很多人在尝试运行AI代理时,会遇到算力不足、环境依赖冲突以及模型量化导致的性...AI智能# GPU# 工作流# 开源工具1个月前2300