开源AI模型本地化部署:从Muse Glimmer到LoRA微调的实操步骤随着Meta开源Muse Glimmer模型的发布,开源AI开发者迎来将大型模型部署到本地的全新机遇。Muse Glimmer作为30B参数的开源模型,采用Apache 2.0协议,专为本地常驻Age...AI智能# 微调# 推理加速# 显存2个月前1700
企业私有化部署小模型的“性价比”陷阱:什么时候该放弃本地化?在数字化转型浪潮中,许多CTO与IT架构师正面临一个关键抉择:是继续依赖公有云API服务,还是投资私有化部署小模型以保障数据安全和降低长期调用成本?私有化小模型确实能在算力成本、维护人力与模型精度三者...AI智能# AI应用# GPU# 医疗1个月前1650
美国防务AI部署协议释放了什么信号:高敏感场景落地应先审查哪些条件高敏感场景引入人工智能,最容易被误解成一场“能力采购”:模型能否更快整理信息、辅助研判、缩短流程,似乎决定了部署价值。但美国防务部门与多家 AI 公司签署机密系统部署协议所释放的更重要信号是,真正困难...AI智能# 人工智能# 效率提升# 数据治理1个月前1650
工业大模型项目卡住时,优先补数据基建还是先换更强模型工业大模型项目卡住时,最容易出现的误判是:模型效果不理想,就继续堆参数、换架构、加算力。但在制造与能源场景中,问题往往不在模型“还不够强”,而在于设备数据彼此不一致、来源无法追溯、关键样本覆盖不足。先...AI智能# 推理优化# 数据清洗# 模型训练1个月前1600
端侧AI推理成本下降之后,哪些边缘场景现在值得优先部署端侧AI的推理成本正在快速下降,这已经不是一个趋势判断,而是正在发生的现实。国产芯片的迭代、轻量化模型的成熟以及推理优化技术的进步,让原本只属于云端大厂的算力能力,开始下沉到普通的终端设备上。对于企业...AI智能# 医疗# 推理优化# 模型压缩1个月前1450
具身智能的“大脑”之争:宇树机器人等硬件厂商对通用大模型的依赖与突破2025年,具身智能首次被写入《政府工作报告》,机器人产业随之从“动起来”的阶段,快速转向“真正完成一件事”的新考场。但一个微妙的分歧正在硬件厂商之间浮现:当机器人需要理解复杂指令、规划长程动作时,究...AI智能# 具身智能# 数据隐私# 模型蒸馏1个月前1400
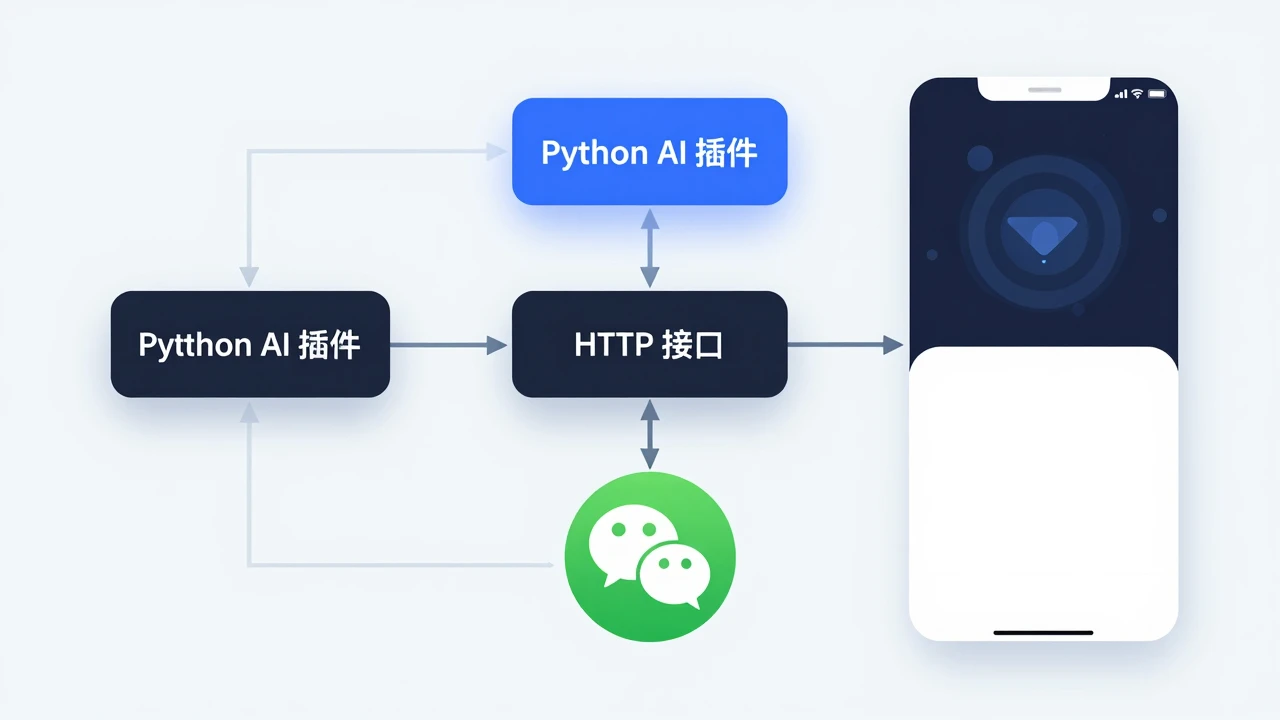
从零到一的AI插件开发:Python 与微信小程序双平台实战AI 插件从零到一:Python 编写与微信小程序集成实战 在开发者想要把自己的大模型能力快速嵌入微信小程序时,往往面临「后端服务如何暴露」与「前端如何调用」的双重难题。本文以单体 Python 插件...AI智能# 快速迭代# 模型部署2个月前1380
模型量化与蒸馏在推理加速中的权衡与部署方案:跟朋友聊聊怎么落地本文面向AI工程师,深入对比模型量化与蒸馏在推理加速中的原理、收益与代价,分析量化误差、蒸馏训练成本等关键权衡,并提供量化感知训练、蒸馏后量化等混合部署方案,帮助你在实际项目中做出合理选型并顺利落地。AI智能# 推理加速# 模型部署# 模型量化2个月前1260