企业采用开源大模型时,低成本优势之外还应核对哪些条件中小企业在评估开源大模型时,最先被打动的往往是“调用几乎不用花钱”。授权费用确实可能很低,可项目一旦进入部署,机器、调优、值班和后续迭代都会进账。公开讨论里并不少见这样的卡住:开源路线要自己扛运维,商...AI智能# 人工智能# 多模态# 大模型1个月前2150
Qwen3.8-27B 本地运行指南:17GB 显存环境下如何平衡性能与速度阿里把 Qwen3.8-27B 推到消费级硬件上时,最吸引人的不是参数量本身,而是官方与社区反复提到的一点:合适量化后,大约 17GB 内存/显存量级就能把模型拉起来。对只有一张中端卡、又想本地跑通编...AI智能# GPU# 上下文窗口# 多模态1个月前2150
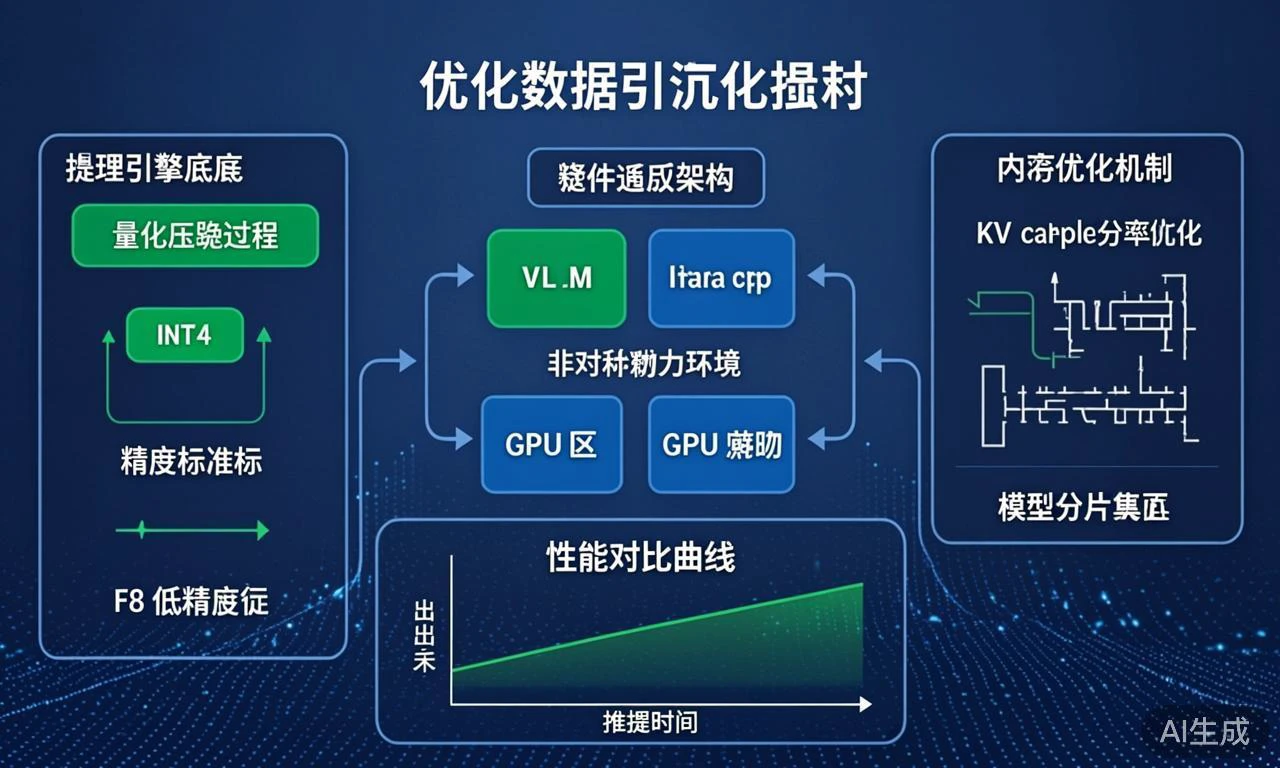
AI 智能体本地部署的‘最后 1 公里’:如何优化推理引擎以适配非对称算力环境本地部署AI智能体时,推理引擎的适配直接决定了部署的成败。在面对CPU算力强但GPU显存不足或非对称算力环境时,单纯依赖硬件往往不够高效。量化技术和先进推理框架的组合是优化这一“最后一公里”的核心策略...AI智能# GPU# 推理引擎# 显存1个月前1950
开源AI模型本地化部署:从Muse Glimmer到LoRA微调的实操步骤随着Meta开源Muse Glimmer模型的发布,开源AI开发者迎来将大型模型部署到本地的全新机遇。Muse Glimmer作为30B参数的开源模型,采用Apache 2.0协议,专为本地常驻Age...AI智能# 微调# 推理加速# 显存2个月前1700
AI 智能体本地部署避坑:从环境依赖到 OpenClaw 运行调优本地把 AI 智能体跑起来,往往不是卡在“会不会写 Prompt”,而是卡在环境:CUDA 对不上、Python 包互相踩脚、运行时版本混用、配置里 skill 或 MCP 连不上。OpenClaw ...AI智能# GPU# Transformer# 工作流1个月前1600
AI智能体本地部署的最后一公里:环境依赖与OpenClaw运行调优企业把 AI 智能体从云端迁到本地,最常踩的坑往往不在模型本身,而在环境依赖和运行调优这两道坎上。云端环境统一、资源充足,很多问题被天然屏蔽;一旦落到端侧或自建服务器,CPU 架构、内存大小、依赖版本...AI智能# GPU# 大模型# 显存1个月前1550
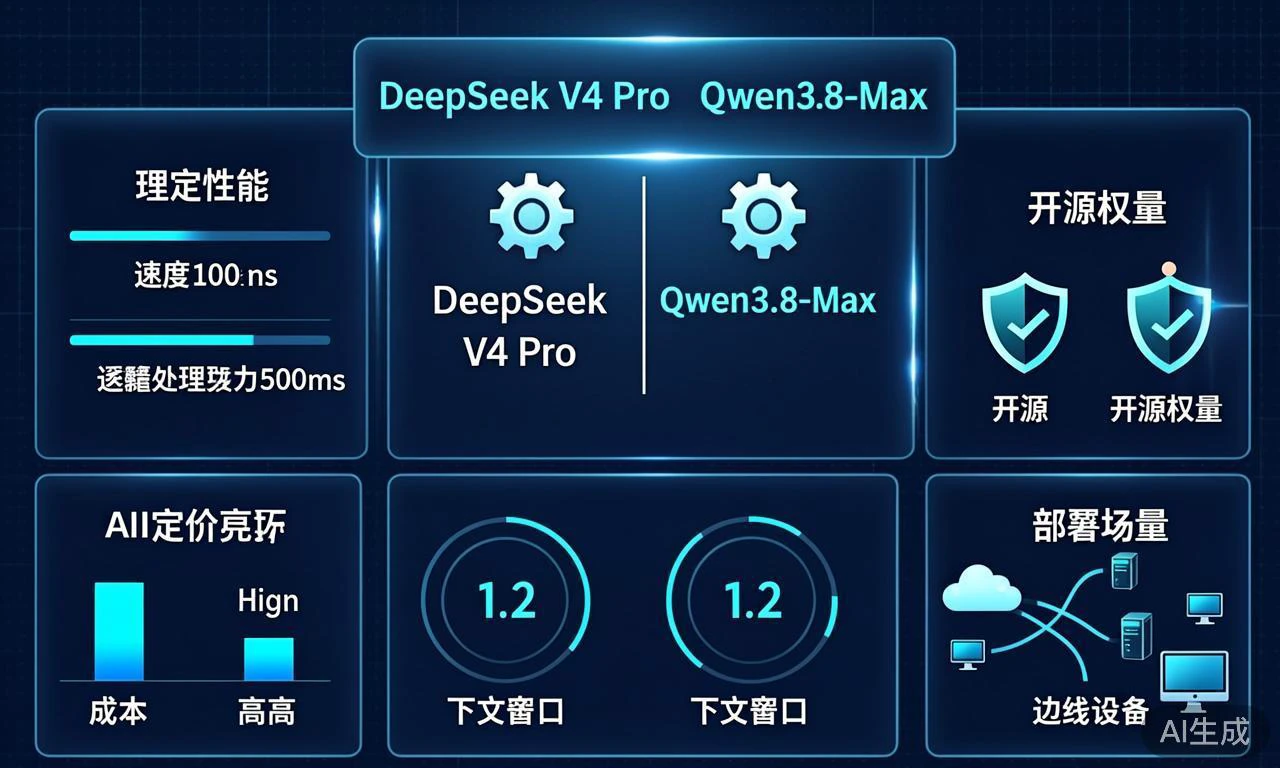
DeepSeek V4 Pro转正与Qwen3.8-Max开源:企业如何评估开源大模型选型近年来,企业技术选型团队常面临类似困惑:是否继续投入自研或依赖闭源API,抑或转向开源大模型?2026年8月前后,DeepSeek V4 Pro正式上线与阿里Qwen3.8-Max开放API及权重权重...AI智能# 上下文窗口# 代码生成# 大模型1个月前1500
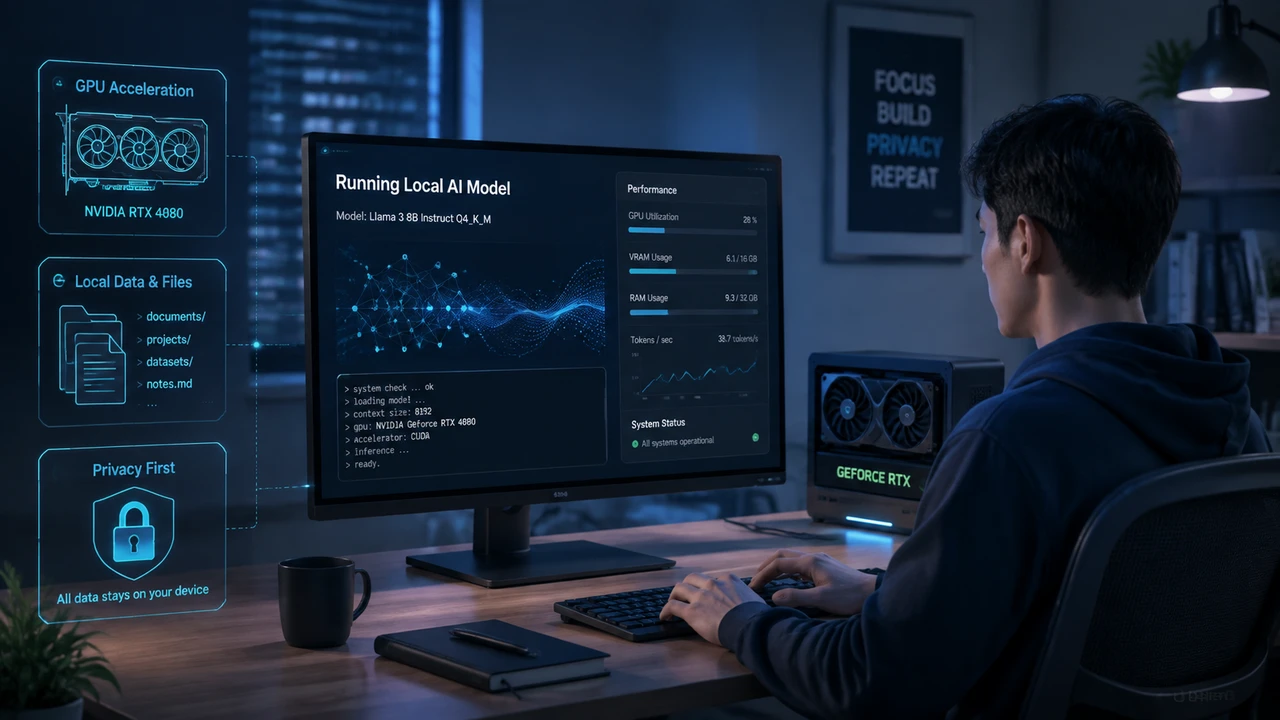
本地运行AI模型前,个人开发者要核算的显存、隐私与维护成本把 AI 模型搬到自己的电脑上运行,听起来像是“省钱、隐私、安全、自由”的一次性解决方案。但对个人开发者和重度用户来说,本地部署不是装好工具就结束的尝鲜项目,而是一项会持续消耗硬件资源、时间和维护精力...AI智能# 代码生成# 向量索引# 多轮对话2个月前1110
开源权重模型 Muse Glimmer 来了:单 GPU 运行 Agent 的本地化可能性把能够规划、调用工具并处理长上下文的 Agent 放进一张个人 GPU,意义不只是“模型可以离线跑”。Meta 推出的开源权重模型 Muse Glimmer 把目标对准了本地常驻 Agent:约 30...AI智能# GPU# 上下文窗口# 多模态2个月前910