企业部署智能体前的合规与数据隐私风险检查清单智能体从试点走向规模化,企业真正卡壳的地方往往不是模型能力,而是数据能不能出域、授权是否闭环、跨端调用有没有留痕。商业化节奏在加快,合规官与技术负责人更需要在上线前把通用检查点摊开,而不是等事故发生后...AI智能# 医疗# 外部检索# 微调1个月前1000
AI模型安全审计:企业如何防止幻觉输出与偏见在企业将大语言模型投入生产环境前,幻觉(模型生成不实信息)和偏见(输出倾向不公平或歧视)往往是最容易被忽视,却会直接影响产品安全与品牌声誉的风险点。通过系统化的安全审计,可以在模型上线前发现并修复这些...AI智能# 大语言模型# 微调# 数据清洗1个月前1550
开源AI模型本地化部署:从Muse Glimmer到LoRA微调的实操步骤随着Meta开源Muse Glimmer模型的发布,开源AI开发者迎来将大型模型部署到本地的全新机遇。Muse Glimmer作为30B参数的开源模型,采用Apache 2.0协议,专为本地常驻Age...AI智能# 微调# 推理加速# 显存1个月前1700
本地小模型(SLM)微调指南:如何在有限算力下打造行业专家模型把本地模型调成“懂行的助手”,关键不在于把参数改得越多越好,而在于把有限显存留给最能产生效果的部分。以 Muse Glimmer 这类约 300 亿参数的本地模型为例,24G 显存足以承担一定范围内的...AI智能# 微调# 数据清洗# 数据集1个月前610
AI 芯片国产化新进展:从 12 英寸晶圆厂投产看算力底座的演进国内谈 AI 国产化,很多人第一反应是模型参数和算法框架,真正卡住节奏的,往往是更底层的算力硬件能不能稳得住、扩得开、用得起。近期安徽在 12 英寸晶圆制造与存储芯片领域的推进,把讨论重新拉回“底座...AI智能# 大模型# 微调# 模型训练1个月前1360
Claude 引入文本水印:企业在 AI 内容透明度合规上面临的新挑战Claude 为生成文本加入不可见标记后,企业面对的就不再只是“能不能使用 AI”的问题,而是要回答:这段内容从哪里来、经过谁审核、对外发布时是否需要说明,以及人工改写之后还能否追溯。 Claude ...AI智能# 人工智能# 合规# 微调1个月前760
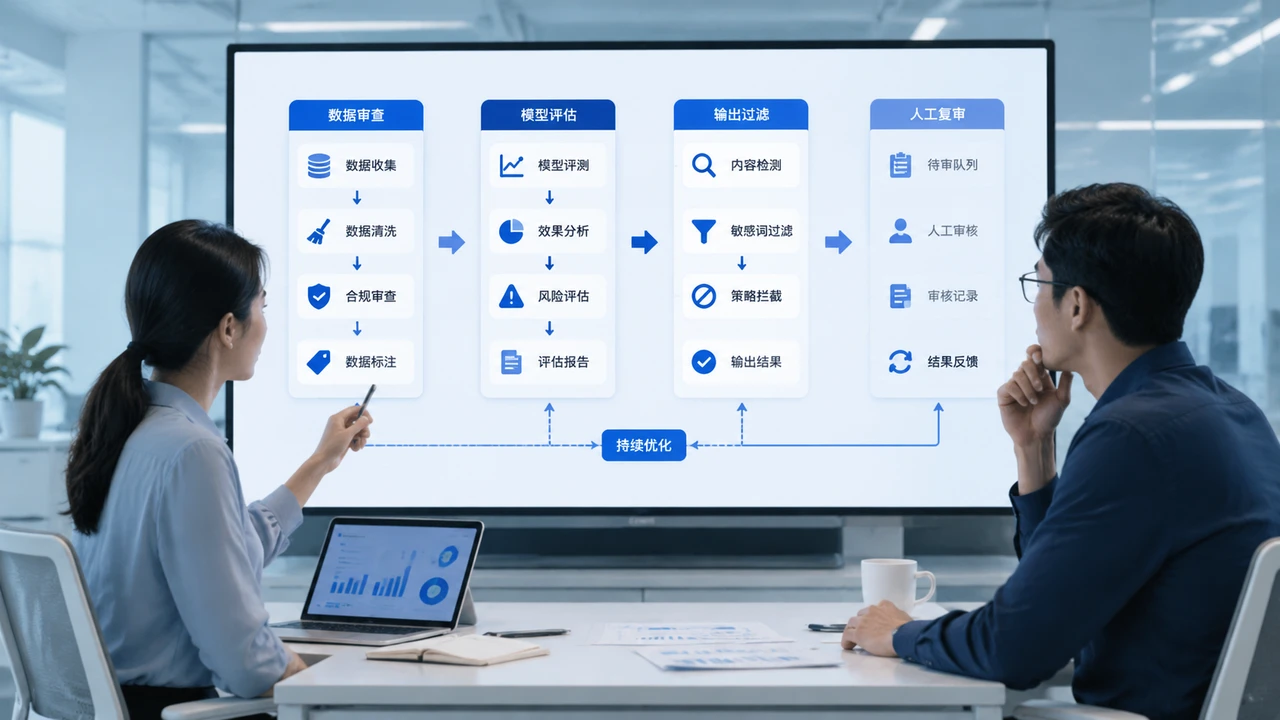
AI生成内容治理框架:企业如何防止幻觉与偏见很多企业把 AI 内容治理理解成发布前的“敏感词过滤”,但真正的风险往往更早出现:训练数据带着偏差,知识库混入错误信息,模型为了补全答案而虚构事实,审核人员又因为流程不清而放行。对内容平台而言,治理目...AI智能# 微调# 数据质量# 模型微调1个月前610