排序
开源AI模型本地化部署:从Muse Glimmer到LoRA微调的实操步骤
随着Meta开源Muse Glimmer模型的发布,开源AI开发者迎来将大型模型部署到本地的全新机遇。Muse Glimmer作为30B参数的开源模型,采用Apache 2.0协议,专为本地常驻Age...
在线平台与企业驱动下的ai 教程变革:谁在教、何时起、如何教,以及为何迫在眉睫
导语:2026年8月,全球在线教育平台、高校与大型科技公司在全球范围内加速更新和推出ai 教程(谁),以应对近三年生成式模型与自动化工具在企业生产力中的快速渗透(何时、为何)。这些课程主要通过模块化在...

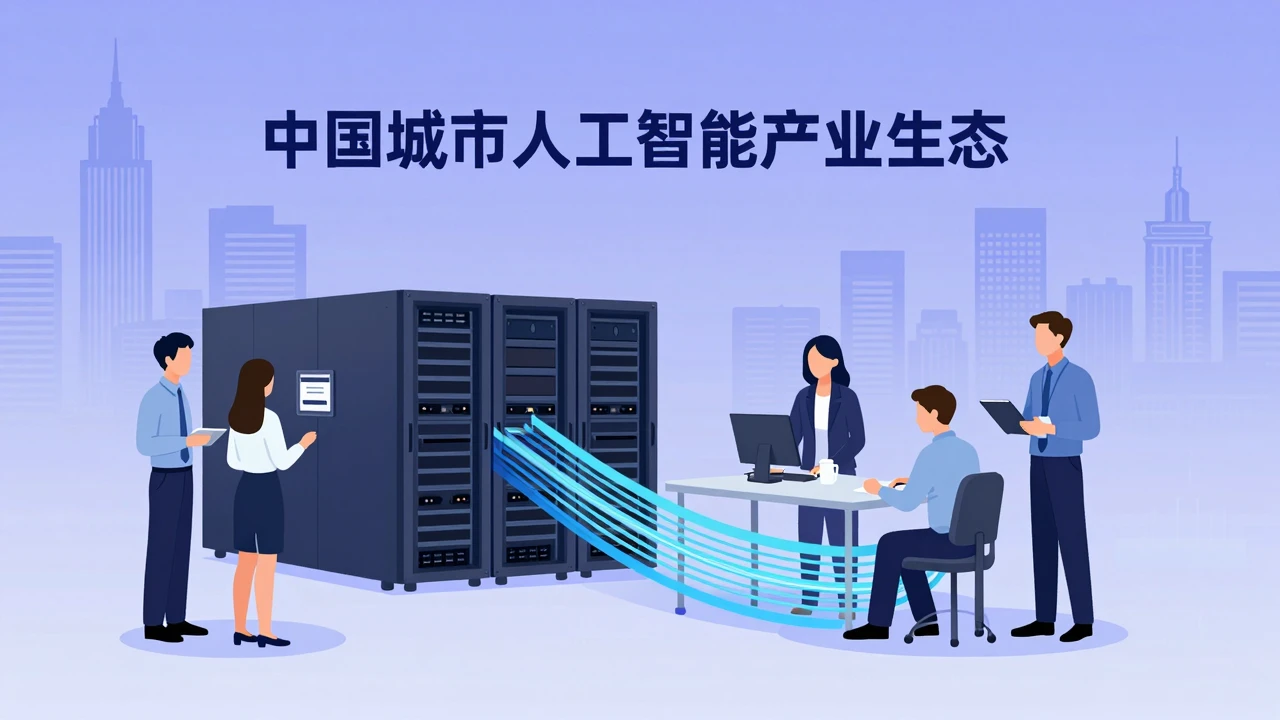
地方AI产业生态如何形成:从模型能力转向人才、算力与应用协同
地方人工智能产业生态的竞争,已经不只是“有没有大模型”的竞争。对地方产业部门、园区运营者和创业团队而言,更关键的问题是:模型能力如何接上稳定的算力供给,技术人才如何进入产业链,又怎样在真实应用中形成可...
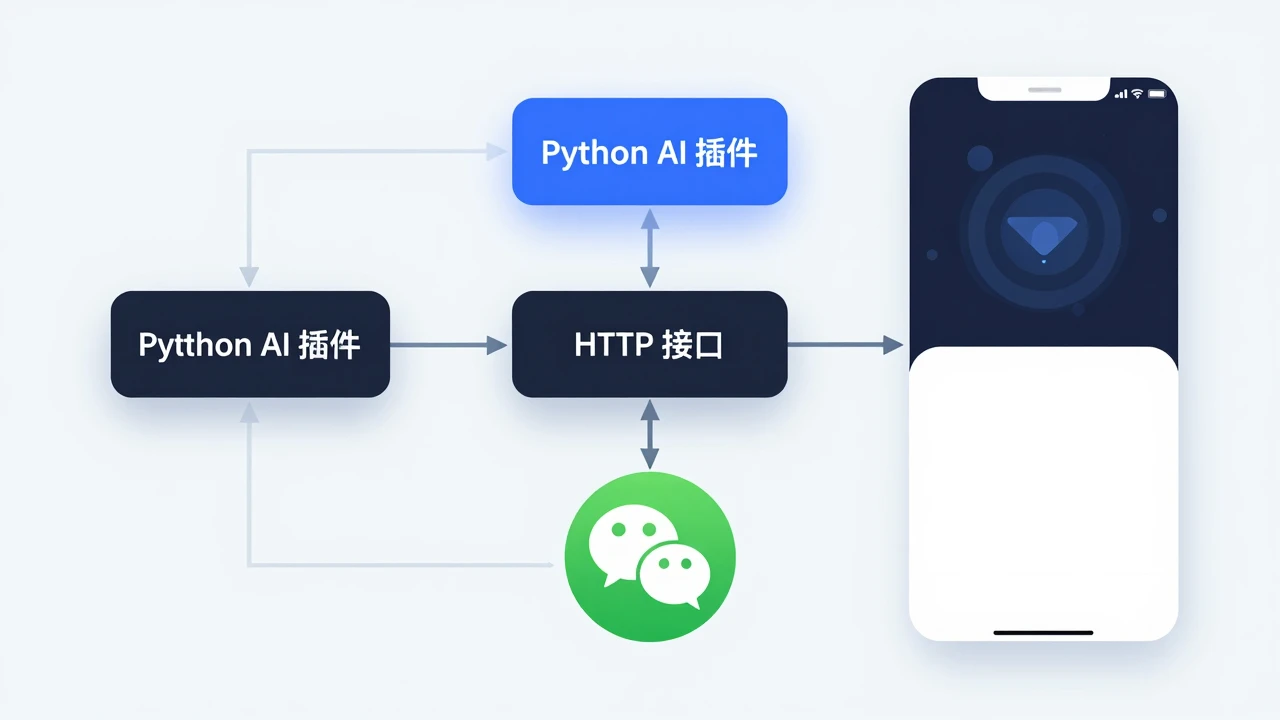
从零到一的AI插件开发:Python 与微信小程序双平台实战
AI 插件从零到一:Python 编写与微信小程序集成实战 在开发者想要把自己的大模型能力快速嵌入微信小程序时,往往面临「后端服务如何暴露」与「前端如何调用」的双重难题。本文以单体 Python 插件...
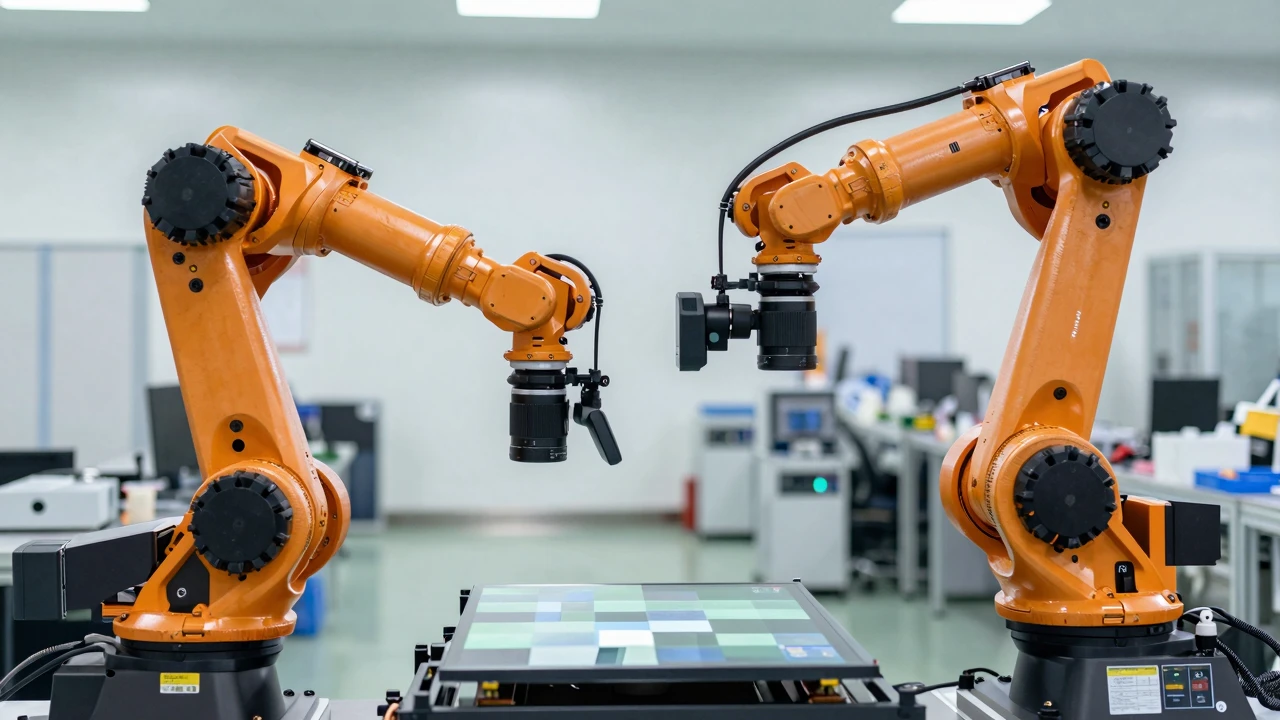
AI质检落地制造业:从缺陷识别到产线联动的完整方案
AI视觉质检在制造业的落地并非一次性技术投入,而是需要在数据、模型、硬件和生产管理四个层面协同推进的系统工程。下面从数据采集到产线联动,逐步拆解实现路径,并结合TCL星智大模型在显示面板检测中的实践...
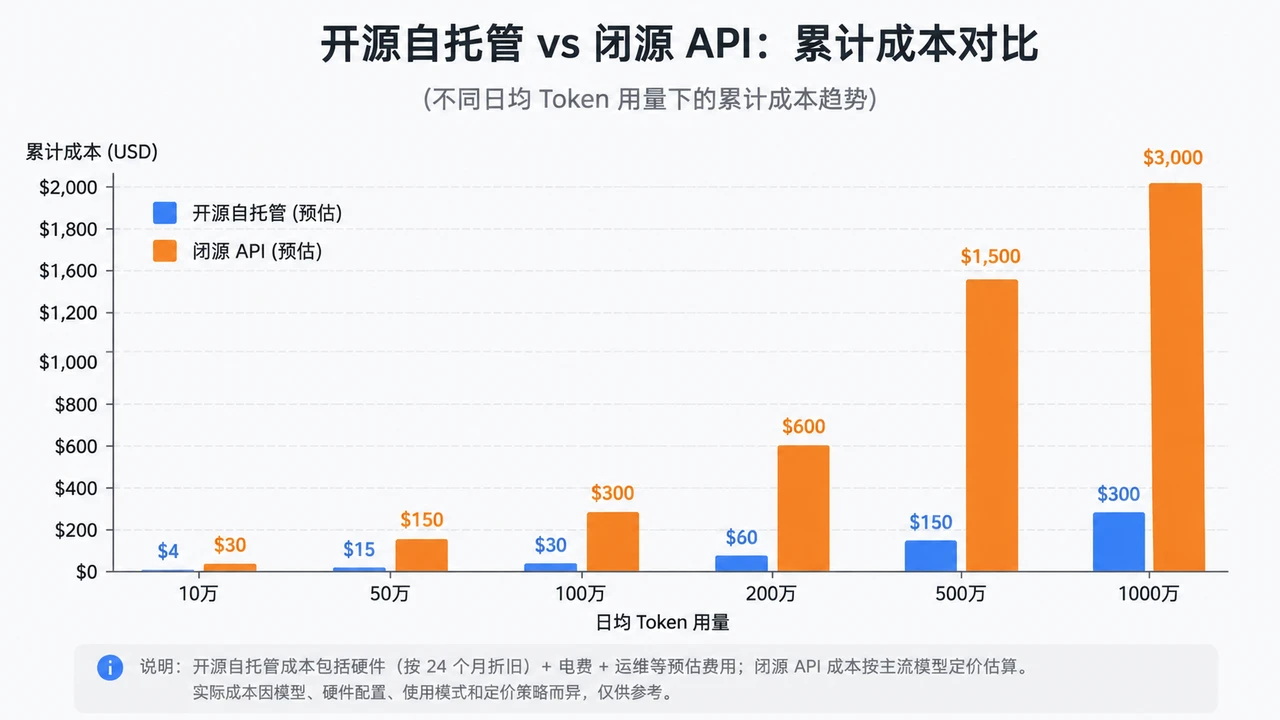
企业部署大模型:选开源还是闭源?从成本、可控性到生态全面对比
当企业决定引入大模型时,开源与闭源的抉择往往成为技术路线上的第一个分水岭。开源模型(如千问、Llama)以开放权重和高度可定制吸引着具备技术实力的团队,而闭源模型(如GPT-4、Claude)则以开箱...
模型量化与蒸馏在推理加速中的权衡与部署方案:跟朋友聊聊怎么落地
本文面向AI工程师,深入对比模型量化与蒸馏在推理加速中的原理、收益与代价,分析量化误差、蒸馏训练成本等关键权衡,并提供量化感知训练、蒸馏后量化等混合部署方案,帮助你在实际项目中做出合理选型并顺利落地。




