生成摘要
想跟唱却被原唱盖过,做视频找不到干净伴奏,想重混又无法拆分人声与乐器——这些需求都指向同一道难题:音乐音频分离。过去依赖专业录音棚,如今借助Spleeter、Demucs、UVR5等深度学习工具,普通人在电脑甚至手机上就能完成,但效果参差、操作有门道。从频谱原理到在线网站、桌面软件与手机App的取舍,再到源文件质量、模型选择与后期微调三大关键,怎样才能避开"一键完美"的陷阱,真正拆出可用的人声或伴奏轨?
— AI 生成,仅供参考
为什么你需要音乐音频分离人声伴奏
喜欢一首歌,想跟着唱却嫌原唱太吵;做视频需要干净的背景音乐,但找不到官方伴奏;或者你想重新混音,把人声和乐器拆开单独处理——这些场景都指向同一个需求:音乐音频分离人声伴奏。过去这需要专业录音棚和昂贵软件,现在借助算法和工具,普通人在电脑甚至手机上就能完成。不过,效果参差不齐,操作也有门道。这篇文章就帮你理清思路,少走弯路。
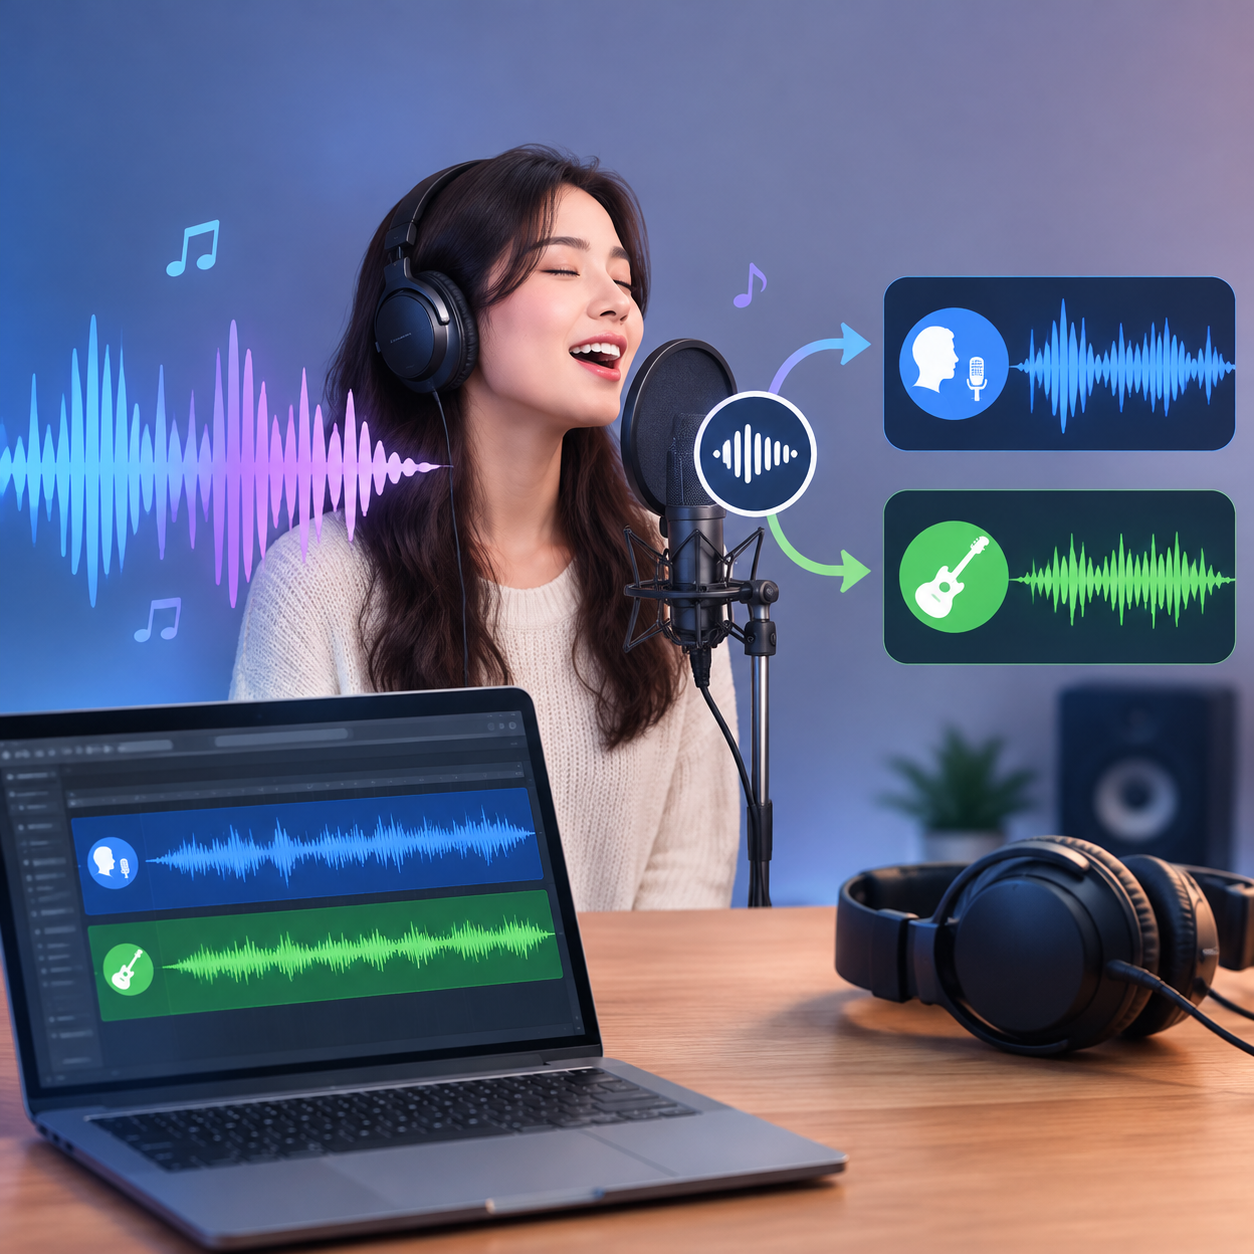
音频分离到底是怎么做到的
从“频谱”说起
一首歌的波形里,人声、鼓、贝斯、吉他等所有声音混在一起。但它们在频率和时间上的分布有差异:人声通常集中在中频,且谐波结构比较规律;鼓点有强烈的瞬态;贝斯在低频。分离算法要做的,就是从混合信号中“认出”哪些部分属于人声,哪些属于伴奏。
两种主流思路
- 传统信号处理:比如独立成分分析(ICA),假设各声源统计独立。对简单混音有效,但面对复杂编曲往往力不从心。
- 深度学习:目前的主流。用大量“人声+伴奏”配对数据训练神经网络,让模型学会预测人声的频谱掩码。代表模型有Spleeter、Demucs、MDX-Net等。它们能处理流行、摇滚、电子等多种风格,分离质量远高于传统方法。
你不需要理解网络结构,只需要知道:深度学习工具是当前音乐音频分离人声伴奏的最佳选择,但不同模型擅长的风格不同,多试几个往往有惊喜。
常用工具怎么选
在线网站:零门槛,适合快速尝鲜
像Vocal Remover、Moises、LALAL.AI等,上传文件就能分离,通常免费版有时长或音质限制。优点是打开浏览器就能用,不用装软件;缺点是隐私和文件大小受限,且部分网站排队慢。
桌面软件:可控性强,适合反复调整
- Spleeter:Deezer开源,有命令行和GUI版本,免费。分离速度快,但高频细节偶尔丢失。
- Demucs:Facebook出品,质量优秀,支持人声、鼓、贝斯、其他四轨分离。需要Python环境,适合愿意折腾的用户。
- UVR5:全称Ultimate Vocal Remover,图形界面,集成了多种模型,可批量处理,是目前社区里很受欢迎的选择。
手机App:随时随地,但别期待太高
部分App如Moises、AudioJam提供移动端分离,适合练习或简单创作。受限于手机算力,复杂歌曲的分离效果通常不如桌面端。
实操步骤与参数建议
第一步:准备高质量源文件
尽量用无损格式(WAV、FLAC)或高码率MP3。低码率文件本身已经丢失细节,分离后瑕疵会更明显。
第二步:选择合适的模型
以UVR5为例,人声分离常用MDX-Net系列或VR Architecture系列。如果歌曲是摇滚或金属,可以试试针对乐器优化的模型;如果是流行或民谣,默认的人声模型通常够用。多跑几个模型,对比试听。
第三步:调整输出参数
- 人声提取:有些工具提供“人声+和声”选项,如果你需要伴唱,可以保留和声。
- 伴奏提取:注意检查低频是否被削弱,必要时用EQ稍微补偿。
- 去混响:部分模型附带去混响功能,但过度使用会让声音发干,谨慎开启。
第四步:后期微调
分离后的人声或伴奏往往有残留。可以用音频编辑软件(如Audacity)做简单处理:对人声轨,用频谱修复去掉明显的伴奏残留;对伴奏轨,用窄带EQ衰减人声频段。但别过度,否则会引入新的失真。
注意事项与常见误区
- 没有完美的分离:任何工具都会留下痕迹,尤其是人声和乐器频率重叠严重时。接受一定瑕疵,或考虑重新编曲。
- 版权问题:分离出的伴奏或人声,如果用于商业发布,需要获得原作品版权方的授权。个人练习通常没问题,但公开传播要谨慎。
- 不要迷信“一键完美”:在线工具宣传得再好,实际效果也取决于歌曲本身。多工具交叉验证,取长补短。
- 硬件有要求:深度学习分离比较吃CPU/GPU,老电脑处理一首歌可能要好几分钟,耐心等待。
总结
音乐音频分离人声伴奏已经从专业领域走向大众。核心思路是借助深度学习模型,把混合音频中的不同声源“拆开”。对于普通用户,建议先从在线工具或UVR5这类图形化软件入手,熟悉流程后再尝试Demucs等更灵活的方案。记住:源文件质量、模型选择和后期微调,三者共同决定最终效果。多试多听,你也能得到可用的伴奏或人声轨。
© 版权声明
文章版权归作者所有,未经允许请勿转载。